Разрыв между первой и второй моделями в Artificial Analysis Intelligence Index v5.0 составил всего один балл. Я считаю победу Google Gemini 4 Carbon важной, но не окончательной: по прикладным задачам картина сложнее. Модель набрала 59 баллов и сместила Claude Opus 5.5 с вершины рейтинга, на которой та продержалась сутки после обновления методики 27 октября.
Что показал Intelligence Index v5.0
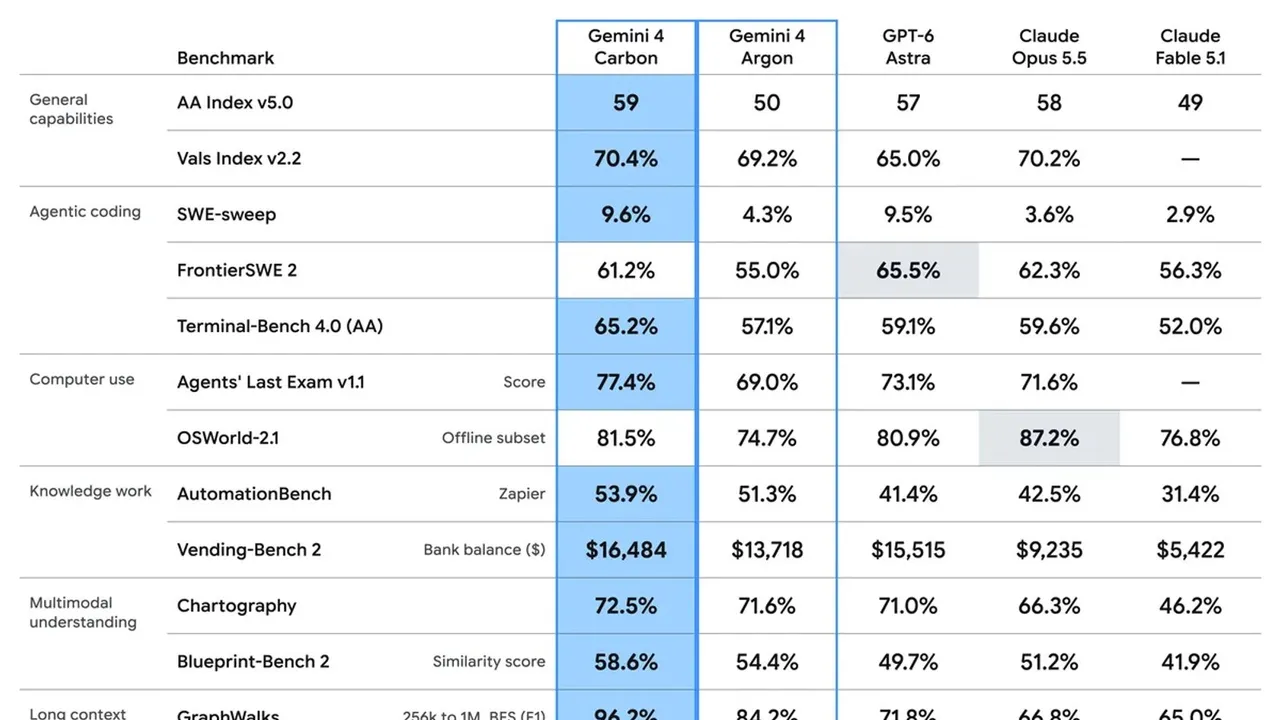
Gemini 4 Carbon набрала 59 баллов и заняла первое место, опередив Claude Opus 5.5 на один балл. В четырёх из девяти оценок она стала лучшей: HLE-Diamond, Terminal-Bench-Science, AA-Omniscience и AutomationBench-AA.
Позади остались GPT-6 Astra с 57 баллами и предыдущая модель Google, Gemini 4 Argon, с 50 баллами. Отрыв в один-два балла я оцениваю как фотофиниш: индекс v5 собирали так, чтобы наказывать модели за заучивание тестов, и на разных подвыборках лидер меняется.
Отдельно выделю AA-Omniscience v1.1: Carbon получила 54 балла против 48 у Opus 5.5. Уровень галлюцинаций у Carbon составил около 11%, у конкурента в тех же замерах — около 50%. Для тех, кто использует модель для разбора документов и сверки фактов, эта разница важнее строчки в рейтинге.
Кибербезопасность как главный аргумент
В тестах кибербезопасности Carbon показала 88,2% при поиске уязвимостей в SEC-bench Pro, 54,8% при эксплуатации в ExploitGym и 71,0% при патчинге в CWE-bench. Google ставит эти цифры первой строкой анонса, и понятно почему: по словам компании, команда Chrome оценила качество патчей Carbon более чем в десять раз выше, чем у фронтирной модели другой лаборатории, которую не называют.
В бенчмарке Gray Swan, проверяющем устойчивость к косвенным prompt injection, успешных атак на Carbon было 0,0% против 0,7% на Argon. Доля успешного читерства на Terminal-Bench 4.0 снизилась до 0,0%.
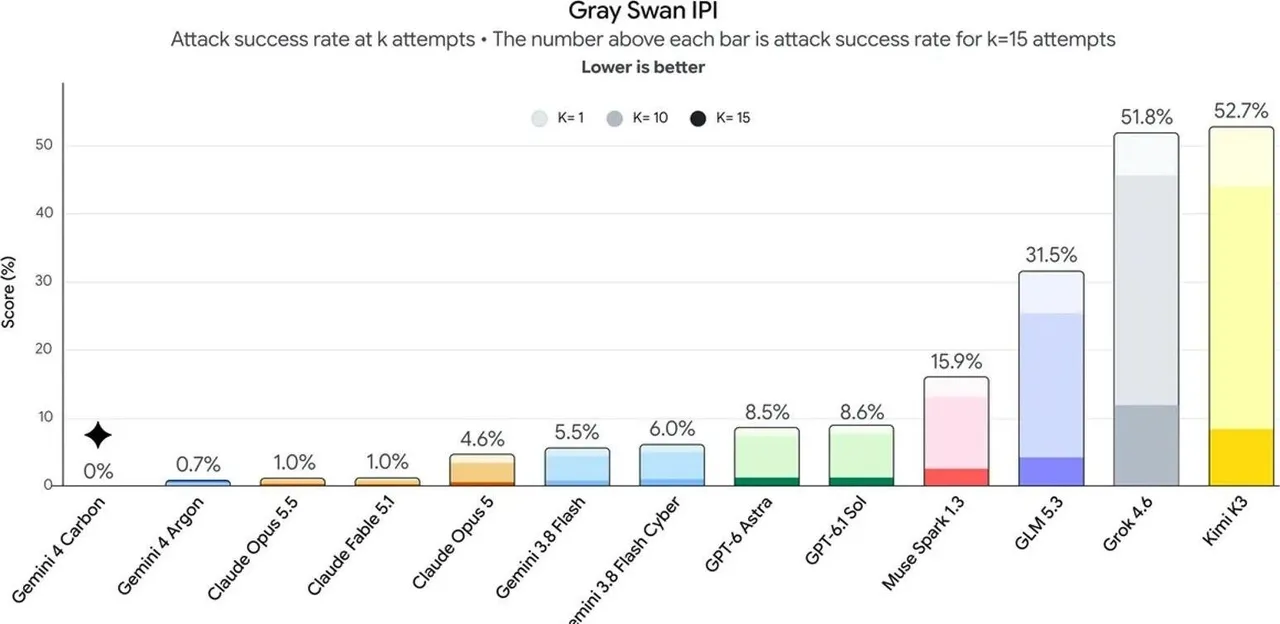
Оговорка существенная: внешние тесты проводили без guardrails, а результаты привела сама Google. Независимого воспроизведения всех замеров пока нет, поэтому к таблице компании я отношусь как к заявке, а не как к протоколу испытаний.
Где Carbon проигрывает
В агентном кодинге и работе с интерфейсами Carbon уступает конкурентам: Claude Opus 5.5 лидирует в Coding Agent Index и OSWorld-2.1, а OpenAI — на FrontierSWE 2. У Opus 5.5 в Coding Agent Index 62 балла против 59 у Carbon. В OSWorld-2.1 он показывает 87,2% против 81,5%, а на FrontierSWE 2 впереди уже OpenAI: 65,5% против 61,2% у Carbon.
| Модель | Intelligence Index v5.0 | Coding Agent Index | OSWorld-2.1 | FrontierSWE 2 | Цена вход/выход за 1 млн токенов |
|---|---|---|---|---|---|
| Gemini 4 Carbon | 59 | 59 | 81,5% | 61,2% | $4 / $20, на старте $2 / $10 |
| Claude Opus 5.5 | 58 | 62 | 87,2% | 62,3% | $4 / $20 |
| GPT-6 Astra | 57 | — | 80,9% | 65,5% | $10 / $50 |
| Gemini 4 Argon | 50 | — | 74,7% | 55,0% | $4 / $20 |
Цена и доступность Gemini 4 Carbon
Оценочная стоимость одной задачи в индексе для Carbon составляет $7,76 против $10,04 у Opus 5.5 и $6,25 у GPT-6 Astra. Стартовая цена API — $2 за миллион входных токенов и $10 за миллион выходных. После окончания промопериода она составит $4 и $20 соответственно, а на кэшированные входные токены действует скидка 95%.
По цене Carbon находится ровно между двумя конкурентами. На мой взгляд, это самое честное описание её позиции.
Попробовать модель пока нельзя: с этой недели доступ к ней получили отдельные специалисты по киберзащите через программу Fairwind. Затем круг пользователей расширят за счёт доверенных партнёров, но сроки для разработчиков и бизнеса Google не называет. Для СНГ это значит, что локальных тарифов и корпоративных условий придётся ждать ещё дольше, чем глобального API.
Google также проводит добровольное предрелизное тестирование модели правительством США. Такой порядок выпуска я считаю разумным для инструмента, который умеет искать и эксплуатировать уязвимости.